很多人在第一次听说 Rollup 时,都会遇到一个很反直觉的说法:Rollup 能把“一万笔交易压成一笔”。
这句话听起来像是在说文件压缩——就像把一个很大的 zip 文件塞进一个小小的信封,然后再寄到以太坊上。但如果真是这样,问题就来了:如果 Rollup 只是把数据压小了,那以太坊凭什么相信这些交易真的发生过、而且结果是对的?压缩文件本身并不会让交易变得可信。
要理解 Rollup,关键不是去想“数据怎么变小”,而是去想“以太坊原来在做什么工作,Rollup 又把这部分工作搬到了哪里”。这篇文章会沿着这个问题一步步展开:以太坊为什么处理不了更多交易,Rollup 到底做了什么,它的安全性来自哪里,以及为什么它仍然不是无限扩容。
为什么需要把一万笔交易“压成一笔”
先看以太坊本身在做什么。
以太坊(Ethereum)是一条 Layer 1 区块链,也就是通常说的 L1。在 L1 上,每一笔交易都需要被网络中的大量节点验证、执行,并更新全网的账户状态。这里的“执行”不是简单记录一下,而是真的运行交易逻辑:转了多少币、调用了哪个合约、余额怎么变,都要被算一遍。
这个设计是以太坊安全性的来源,但也是它的瓶颈。交易越多,全网络需要重复做的工作就越多。 每笔交易都要被成千上万个节点各自执行一次,成本随着交易数量线性上升。网络拥堵时,用户为了抢先被处理,只能不断提高手续费,于是交易变得又慢又贵。
于是很自然的想法出现了:能不能不把每一笔交易都放到 L1 上逐笔执行?
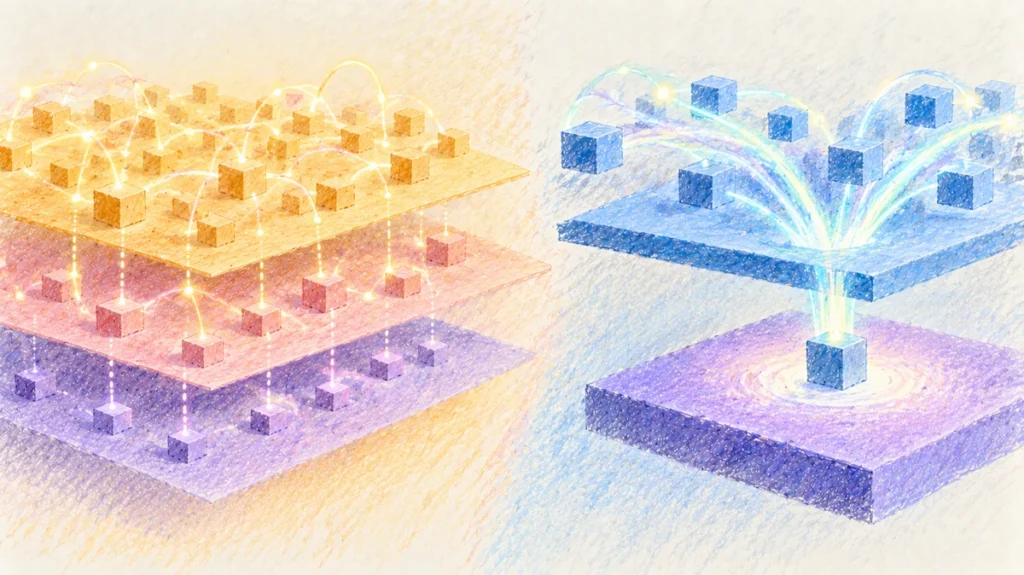
假设有一万笔交易。如果它们全都在 L1 上逐笔执行,那 L1 就要执行一万次。但如果换一种方式——在别的地方把这一万笔交易执行完,然后只把“这一批交易的数据”和“执行后的结果”发布到 L1 上——L1 就不再需要重复执行这一万次,它只需要接收这批数据、记录这个结果。
这就是“一万笔压成一笔”的真正含义。它并不是把信息删掉或者无损失地压缩,而是把一万笔交易的验证负担打包成一份批次,让 L1 从“逐笔执行的工人”变成“核对结果的结算方”。
需要强调的是,这里成本下降的原因,不是数据文件变小了多少,而是 L1 需要做的事情变了。它不需要再执行一万次计算,而主要承担发布这批数据的成本。这也解释了为什么这种方式能同时保持较低成本和较高安全性——执行的活被搬走了,但结算仍然留在以太坊上。
Rollup 的核心不是压缩,而是执行下放
理解了上面的思路,就能看清 Rollup 的基本结构。
Rollup 是一条运行在以太坊之外的链,属于 Layer 2(L2)的一种。用户平时是在这条 Rollup 链上发起交易,而不是直接在主网上操作。这些交易被一个负责排序和执行的角色接收——通常叫排序器(sequencer)或运营者(operator)。它负责把交易排好顺序、执行,然后把一段时间内的交易打成一个批次。
这时候,很多人会误以为:既然执行都在链下了,那以太坊岂不是什么都不知道?并非如此。
关键在于,执行虽然发生在链下,但结果和交易数据仍然要发布到 L1。具体来说,Rollup 会把两样东西提交到以太坊上的 Rollup 合约:
- 这一批交易的数据本身,或者足以恢复出这些数据的信息;
- 执行之后的状态承诺,通常表现为一个新的状态根(state root)。
状态根可以理解成“对当前所有账户状态的一小段摘要”。它就像一本书的目录指纹:你不需要把整本书抄下来,只要记住这个指纹,就能代表某一时刻的状态。一旦这批交易改变了账户余额,状态根也会随之变化。
那么 L1 是怎么“相信”这个结果的呢?答案是:L1 合约不需要重新执行每一笔交易,它只需要验证这个批次的承诺是否合法。在不同的 Rollup 方案里,这个“合法”的判定方式不一样,我们稍后会详细讲。但核心逻辑是一样的:L1 从执行者变成了结算和验证者。
一个常见的类比是报销:员工自己处理报销单,同时保留原始凭证;财务不需要重新把每一笔钱都付一遍,只需要核对汇总表,并在需要时翻看原始凭证。这个类比有助于理解“执行下放”,但它有一个重要的局限——现实中财务可能出于信任而直接付款,而 Rollup 不能只依赖对排序器的信任,它必须靠数据可用性和证明机制来保证任何人都能验证结果。这一点是接下来要讲的重点。
数据可用性:为什么那“一笔”必须让所有人能查账
现在到了 Rollup 安全性最容易被忽略、也最关键的一环。
想象一种情况:某个批次只向 L1 发布了一个哈希(hash),也就是那批交易数据经过计算得到的一串指纹,但原始交易内容完全没有公开。会发生什么?
外人只能看到一个指纹,却看不到任何一笔交易原文。这意味着没有人能重建这批交易执行前和执行后的状态,也就没有人能验证排序器提交的结果是否正确。排序器完全可以在链下偷偷把状态改错,然后只把对应的摘要发到 L1,而外部观察者根本无从发现。
这就是为什么数据可用性(data availability)如此重要。它要求交易数据,或者至少是足以恢复出全部状态的信息,被真实地发布到 L1 上,让任何人都能下载、重建状态、独立计算。数据可用性解决的不是“结果对不对”,而是“你有没有资格去验证结果”。
一旦数据可用,接下来的一切才成立:
- 任何人都能拿到这批交易,自己重放一遍,看看新状态根是否正确;
- 如果发现错误,就能发起争议或证明;
- 即使排序器想作弊,也会被公开的数据暴露出来。
反过来说,如果没有数据可用性,那么无论是欺诈证明还是有效性证明,都可能被架空的——你连原始数据都拿不到,又怎么去证明它是错的呢?这就是为什么一个只发布摘要、不发布数据的系统,哪怕有再精巧的证明机制,安全性也会大打折扣。
一个技术上的对比可以说明这一点:如果只发布哈希,外人看不到任何交易原文;如果把原始交易数据作为数据(例如以 calldata 或 blob 的形式)发布到 L1,那么任何人都能下载这些数据并重建状态。不同 Rollup 当前选用哪种数据发布方式可能会有差异,但共同的底线是——必须让外部有足够的数据去验证,而不是只能听运营者的一面之词。
数据可用性成本,也正是 Rollup 需要承担的一项 L1 成本。这部分成本决定了吞吐量上限,这一点在最后一节会再次提到。
两种路径:Optimistic Rollup 与 ZK Rollup
现在问题变成了:数据发布了,L1 又不想重新执行全部交易,那它到底怎么判断这批结果是对的呢?目前主要有两种技术路径。
Optimistic Rollup:默认正确,事后挑战
Optimistic Rollup 的思路很直接:默认每批交易都是正确的,先把结果发布上去,不立刻检查。为了给大家一个发现错误的机会,它会设定一段挑战期(challenge period)。
在挑战期内,任何人如果发现了错误,都可以提交一份欺诈证明(fraud proof),指出某批交易的执行结果和实际数据不一致。如果证明成立,错误的交易就会被回滚,相关的验证者可能受到经济惩罚。如果挑战期内无人提出异议,交易才会被最终确认。
这带来了一个重要的特点:在挑战期结束之前,交易其实还没有真正不可逆。挑战期的长度并不是全网统一固定的,而是由各个协议自行定义,通常以天为单位。所以当你在 Optimistic Rollup 上看到一笔交易“成功了”,要明白它离最终结算可能还差一段时间。
ZK Rollup:自带一张可验证的收据
ZK Rollup 走的是另一条路。它不依赖“事后有没有人举报”,而是在提交批次时,同时附上一份有效性证明(validity proof)。这份证明用密码学方式表明:这批交易确实是从正确的旧状态出发,执行出了正确的新状态。
L1 合约收到证明后,只要验证这份证明是有效的,就可以接受这批交易。因为证明在被验证的那一刻就已经成立,ZK Rollup 不需要漫长的挑战期,能更快获得最终性。
这两种方式的差异可以这样理解:Optimistic Rollup 更像事后审计,给一段时间让问题暴露出来;ZK Rollup 更像每一批交易都自带一张可立即验证的密码学收据。这里要注意,这个类比只是帮助区分两种验证方式,并不能替代对数据可用性和证明机制本身的理解——无论哪种方案,数据可用性都不能省。
两种路径的取舍也很清楚:Optimistic 方案依赖挑战期和经济激励,结构相对简单,但最终性会慢一些;ZK 方案最终性更快,但对证明系统要求更高,生成证明本身也更复杂。但两者的目标是一致的:让 L1 在不需要重新执行全部交易的前提下,仍然能确认结果是否正确。
从用户交易到 L1 结算的完整路径
把前面的机制串起来,就能看到一笔交易从用户点击发送,到最终在以太坊上固化的完整过程。
- 用户在 L2 上签名并提交交易。这笔交易不是发给以太坊主网,而是发给这条 Rollup 链,由钱包完成签名。
- 排序器接收并排序交易。它决定这些交易以什么顺序被处理,然后把它们打包进一个批次。
- 排序器执行交易,更新本地状态。执行完成后,得到新的状态根,以及这一批交易对应的数据。
- 批次数据提交到 L1 的 Rollup 合约。L1 此时记录下这批数据(满足数据可用性),并更新对结果摘要的承诺。
- 根据方案不同,进入结算环节。Optimistic Rollup 会等待挑战期结束;ZK Rollup 会提交有效性证明,等待 L1 合约验证通过。
- 完成 L1 层面的最终确认。到此为止,这笔交易才真正获得了以太坊提供的安全性。
这条路径解释了为什么“在 L2 上执行”和“在 L1 上最终确认”是两件不同的事。你在 Rollup 上看到的即时反馈,来自排序器的执行;而真正让它变得不可逆的,是它在 L1 上完成了结算。两者之间的时间差,在 Optimistic Rollup 上尤为明显。
Rollup 的边界与常见误解
Rollup 确实大幅提升了可用吞吐、降低了成本,但它不是魔法。理解它的边界,才能建立正确的预期。
第一,Rollup 不能无限扩容。它仍然必须把数据发布到 L1,并承担 L1 的数据可用性成本和验证成本。这部分带宽和费用构成了吞吐上限。无论证明机制多高效,只要数据还得往 L1 上发,就会受制于 L1 的数据容量。
第二,Rollup 不等于所有 Layer 2。Layer 2 是一大类扩容方案的统称。Rollup 是其中安全性更接近 L1 的一种路径,它的关键特征正是“把数据发布到 L1”。而状态通道、侧链等其他方案的安全模型并不相同,有的并不依赖把数据发布到 L1。把“所有 L2 都当成 Rollup”会让人错误估计它们的信任假设。
第三,Rollup 上执行不等于立即最终确认。尤其是 Optimistic Rollup,挑战期内的交易仍然可能被回滚。把 L2 上的“成功”当成和 L1 一样不可逆,是一种常见误解。
第四,Rollup 的安全性根植于 L1,但也受 L1 影响。如果 L1 的数据发布出现问题,或者 Rollup 合约实现本身存在缺陷,安全性同样会受到波及。Rollup 把安全性锚定到以太坊,但这不等于它自动获得了以太坊的全部属性。
第五,Rollup 不是把数据藏起来。恰恰相反,它的安全性依赖数据公开可用。一个把交易数据完全隐藏、只发布摘要的系统,严格来说并不具备 Rollup 所需的安全保障。
回到最初的那个问题:一万笔交易是怎么被 Rollup 压成一笔的?
答案不是它把数据像 zip 一样压小了,而是它把交易执行搬到了链下,把交易数据和结果承诺发布到 L1,让 L1 从逐笔执行者变成结算和验证者。L1 不再需要重复执行一万次,但仍然通过数据可用性和证明机制,保留了对结果的验证能力。
Rollup 的安全性并不来自信任某个排序器,而来自它能让大家查到数据、能检查结果。也正因为它必须把这些数据发布到 L1,它的扩容能力始终有上限——这不是缺陷,而是它用安全换取效率时付出的、明确的代价。